Informática geek, matemáticas, pensamiento crítico y alguna otra cosa de vez en cuando.

Showing posts with label Informática recreativa. Show all posts

2017-04-13

Generador de palabras

Hace mucho tiempo, en una gal... Perdón, que me despisto. Hace mucho tiempo, decía, tuve un QL. Era un ordenador bastante interesante. Una de las aplicaciones que incluía era el Archive, un gestor de base de datos con un lenguaje de programación incorporado. Siendo el primer lenguaje estructurado que aprendía, me fascinó el hecho de que no tenía GOTO, y sin embargo se seguía pudiendo hacer lo mismo que en BASIC, pero de forma más ordenada y disciplinada. Además, tenía una característica que no he vuelto a ver en otro lenguaje de programación hasta que apareció el Python 3, y es que permitía usar ñ y letras acentuadas en los identificadores. Pero me estoy desviando de nuevo...

Uno de los programas que hice en Archive era un generador de palabras. La idea era mostrar una lista de palabras generadas, que sonaran más o menos como cualquier otra palabra castellana. Las primeras versiones no eran muy útiles, pero fui refinándolo hasta que estuve satisfecho. Fue divertido; algunos de mis amigos lo encontraron fascinante.

Para hacer un generador de palabras decente, no basta con juntar letras al azar; eso es un poco como usar bogosort para ordenar: la cantidad de palabras siquiera con un mínimo interés es demasiado reducida entre toda la morralla, con lo que uno se cansa antes de encontrar una. Para abordar el problema adecuadamente, hay que tener en cuenta la estructura de la sílaba en castellano.

Las primeras versiones de aquel programa generaban un número al azar de sílabas, escogiendo la cabeza (o ataque, según versiones), cima (o núcleo) y coda también al azar. El resultado fue peor de lo que esperaba. Tenía que tener en cuenta también la frecuencia de las letras y de los componentes de la sílaba, incluyendo el vacío. Con ese y otros refinamientos (como reglas de exclusión, donde «n» no puede ir seguida de «p» y otras), al final conseguí uno que daba un resultado digno de enseñar a mis amigos. Seguía generando bastantes palabras inservibles, como «brunspridreñustro», pero al menos había entre ellas unas cuantas que sí eran buenas.

Lamentablemente, estoy hablando de memoria, porque perdí ese programa cuando devolví el QL. Como ordenador me gustaba, pero el medio de almacenamiento (microdrives) era horrendo, y cada dos semanas me tocaba hacer un viaje al servicio técnico para una alineación de cabezales. Pudo con mi paciencia.

Pero desde entonces siempre he tenido el gusanillo de tener un generador de palabras. Recientemente me puse manos a la obra y me saqué esa espina. Con más bagaje en mi haber, y la experiencia anterior, me decidí a enfocarlo desde un punto de vista que debería generar palabras de aún mejor calidad que aquel programa de Archive.

Para hacer que sonara castellano, la cabeza, cima y coda debían no sólo obedecer las reglas de formación silábica, sino además tener aproximadamente la misma frecuencia que en nuestro idioma. Consideré usar cadenas de Markov, pero rechacé la idea por temor a que no generaran suficiente variedad, que el resultado careciera de «imaginación». En vez de eso, decidí que el programa debía generar sílabas con frecuencias separadas para las sílabas primera, última e intermedias, además de para monosílabos, bajo la hipótesis de que las frecuencias varían mucho en esos casos especiales. Pero ¿cómo obtener esas frecuencias?

La respuesta era obvia: usaría un texto castellano, separándolo en sílabas y sus componentes y computando las frecuencias deseadas. Así que el primer paso sería hacer un separador silábico de textos.

Lo escribí en Python 3. Las expresiones regulares son un invento maravilloso que usado adecuadamente puede ahorrar mucho tiempo, y en este caso la tarea íntegra de la división silábica recae sobre una sola expresión regular. He aquí el programa:


#!/usr/bin/env python3
# encoding: UTF-8
import sys
import re

# Este módulo carece de una tabla de excepciones a las reglas de separación
# silábica. Por ello, algunas divisiones no las hace correctamente.
# Por ejemplo:
#   liando -> li-an-do. Considera 'ia' como diptongo y la divide como lian-do.
#   subrayar -> sub-ra-yar. La divide como su-bra-yar.


expresión_sin_vocales = re.compile('^[^aeiouáéíóúü]*$')

expresión_sílaba = re.compile(
'('
  # ataques normales
  '[bcfgkp][lr]|tr|dr|rr|ll|ch|qu|[bcdfghj-nprstv-zñ]'
  # todas las consonantes a comienzo de palabra
  '|^[^aeiouáéíóúü]+(?=[aeiouáéíóúü])'
'|)' # no usamos '?' porque nos interesa cadena vacía en vez de Null
# núcleo
# palabras como ahu-yen-tar y a-hue-car son un reto para la expresión regular
'([iuü]h?[aeoáéó]h?[iu]|[iuü]h?[aeoáéó]|[aeoáéó]h?[iu](?!h?[aeoáéó])|[iu]h?[iuíú]|[aeiouáéíóúü])'
# coda = todas las consonantes que no empiezan una nueva sílaba
# (así que repetimos la subexpresión del ataque aquí)
'('
  '(?:(?!(?:[bcfgkp][lr]|tr|dr|rr|ll|ch|qu|[bcdfghj-nprstv-zñ])[aeiouáéíóúü])'
   '[^aeiouáéíóúü])*'
')'
)

def silabea(palabra, separar_partes_sílaba = True):
  # si no tiene vocales, devuelve la palabra intacta
  # p.ej. "y", "sr", etc.)
  if expresión_sin_vocales.search(palabra):
    if separar_partes_sílaba:
      return palabra + '::'
    else:
      return palabra

  estado = 0
  cabeza = 0
  cima = 0
  coda = 0
  total = ''
  acumulado = '' # nos servirá para saber si nos dejamos algo al final
  fin_sílaba_anterior = 0
  for sílaba in expresión_sílaba.finditer(palabra):
    # Comprobar si nos hemos dejado algo entre la coincidencia anterior y esta.
    if sílaba.start(0) != fin_sílaba_anterior:
      fragmento = palabra[fin_sílaba_anterior:sílaba.start(0)]
      total = total + '-(' + fragmento + ')'
      acumulado = acumulado + fragmento
      del fragmento
    acumulado = acumulado + sílaba.group(0)
    fin_sílaba_anterior = sílaba.end(0)

    if separar_partes_sílaba:
      total = total + '-' + sílaba.group(1) + ':' + sílaba.group(2) + ':' + sílaba.group(3)
    else:
      total = total + '-' + sílaba.group(0)

  assert(len(acumulado) >= len(total))

  if len(acumulado) > len(palabra):
    total = total + '-(' + palabra[len(acumulado):] + ')'

  return total[1:]


if __name__ == "__main__":
  divide = len(sys.argv) > 2
  for x in sys.stdin.readlines():
    if x[-1:] == u'\n':
      x = x[:-1]

    print(silabea(x, divide))

La entrada debe ser una lista de palabras, a palabra por línea. La salida es la misma lista, pero con guiones entre las sílabas y con símbolos «:» separando cabeza, cima y coda de cada sílaba. Si se añade un argumento cualquiera, entonces no separa los componentes de cada sílaba, sólo las sílabas en sí, es decir, sólo añade guiones. Toma decisiones arbitrarias en casos dudosos, ya que para este propósito no me importa de qué forma se dividan las palabras que admiten más de una separación (como atlántico).

El texto que escogí para extraer las frecuencias fue Fortunata y Jacinta, disponible libremente a través del proyecto Gutenberg. La mayoría del trabajo auxiliar a la separación lo hice con comandos estándar de Unix, sobre todo sed, pero también sort, uniq, tr, cut y otros. La tabla final de frecuencias se puede consultar abriendo el código fuente de esta página. Hay doce tablas en total, correspondientes a ataque (A), núcleo (N) y coda (C) de monosílabos (1), inicios de palabra (I), sílabas medias (M) y finales de palabra (F).

La frecuencia de las longitudes (en sílabas) ha sido también analizada y es respetada por el programa. Puede generar hasta 8 sílabas. Las palabras (sin repetición) más frecuentes en el texto de Galdós son las trisílabas, seguidas de las tetrasílabas. Me remito de nuevo al código fuente para más detalles.

Sigue habiendo algo de morralla en el resultado, pero la densidad de palabras interesantes es ahora muy satisfactoria. Incluso genera con cierta frecuencia una palabra que ya existe o se diferencia en muy poco de una existente. No genera tildes, así que la acentuación es cosa de cada cual. En ocasiones, una palabra es «casi perfecta», a falta sólo de un pequeño toque que le podemos dar manualmente.

Ya sin más preámbulos, he aquí un ejemplo del resultado: una colección de palabras recién generada. ¡Que la disfrutéis!

2010-02-11

Paintfuck

Ya hablamos en el artículo Lenguajes esotéricos sobre Brainfuck, un lenguaje de ocho instrucciones sumamente popular. Tanto, que existen multitud de variantes de dicho lenguaje. He aquí unos cuantos:

  • En COW se representan la mayoría de instrucciones mediante cambios en las mayúsculas de la palabra «Moo». Es una variante de Brainfuck con cinco instrucciones nuevas.

  • FukYorBrane es un lenguaje diseñado para que dos programas en Brainfuck compitan entre sí.

  • Brainfork añade una instrucción para convertir el Brainfuck en multitarea.

  • Boolfuck y Smallfuck son versiones de Brainfuck que operan sobre bits en vez de palabras.

  • Dimensifuck utiliza un casillero n-dimensional en vez de bidimensional.

  • Quantum brainfuck opera sobre qubits en vez de sobre enteros. Está basado en la teoría de computación cuántica.

  • 2L es una variante bidimensional que usa dos símbolos (y el espacio en blanco).

  • Hay muchas más variantes; véase Category: Brainfuck derivatives en la wiki de lenguajes esotéricos.

En particular, el Smallfuck opera sobre un casillero donde cada celda es de un bit. Tiene cinco instrucciones: elimina la entrada y la salida y, como no le hace falta incremento y decremento porque las dos operaciones hacen lo mismo, las sustituye por el comando *, que invierte el bit en la celda actual. Es relativamente sencillo convertir un programa en Brainfuck a Smallfuck (salvo por la entrada/salida), sustituyendo el incremento y decremento por subrutinas que manipulan los bits en bloques de, por ejemplo, 8 bits.

Y del Smallfuck surge el Paintfuck. Es una variante creada por Wouter Visser que utiliza un casillero bidimensional en vez de lineal, lo cual en principio no parece nuevo. Lo que lo hace original es que está pensado para que el casillero sea representado en la pantalla, viendo en tiempo real y de forma animada cómo el programa actúa sobre el mismo.

Las instrucciones < y > son sustituidas por n, s, e, w para los cuatro puntos cardinales respectivos. Las demás instrucciones son idénticas a las de Smallfuck, así que consta de siete instrucciones en total. Todo carácter que no sea una instrucción válida (incluyendo las versiones en mayúsculas de los comandos) se considera un comentario y por tanto no interviene en el programa, pero tampoco causa error. Por ello, es común que los comentarios intercalados se escriban en mayúsculas, para evitar escribir accidentalmente alguna de las letras n, s, e o w que influirían en el comportamiento del programa. El espacio de datos está inicialmente vacío (todo ceros).

Aunque es un lenguaje Turing-completo cuando se aplica a casilleros infinitos en al menos una dimensión, lo cierto es que los casilleros toroidales finitos suelen ser más interesantes. Así, este sencillo programa rellena todo el casillero de unos, aunque no para nunca:

*[e[s]*]

¿Qué hace este programa? Primero, cambia la casilla inicial de 0 a 1. Esto le permite entrar en el bucle. Ya dentro del bucle, se mueve hacia el este y, si da con una casilla que no es cero, se mueve hacia el sur hasta que encuentre la primera que es cero. Si se parte de un casillero vacío, eso debería ocurrir en la línea siguiente, salvo que llegue al punto inicial, en cuyo caso se quedará enganchado indefinidamente en ese bucle. Tanto si va al sur como si no, pone a 1 la casilla actual (era 0 seguro, o de lo contrario no habría salido del bucle anterior) y repite.

Programar en Paintfuck tiene el aliciente de que vemos cómo se desarrolla nuestro programa. Además, trabajar con bits es más simple en general. Entre los programas actualmente escritos en Paintfuck hay, por ejemplo, uno para hacer funcionar el autómata del Juego de la Vida de Conway del que hablamos en la entrada sobre autómatas celulares; también hay otro autómata finito llamado la hormiga de Langton y un contador decimal.

El contador decimal, escrito por un servidor de ustedes, representa cada número dentro de un bloque de 3×5, y se basa en una sugerencia dada en el canal de IRC #esoteric sobre realizar tal contador analizando cada dígito para ver de cuál se trata e incrementarlo. Requirió bastante esfuerzo diseñar la fuente, hallar los píxels distintivos únicos de cada número y analizar los cambios que convertían cada dígito en el siguiente. El programa final es este:

PAINTFUCK PROGRAM BY PEDRO GIMENO 2008-12-01.

swwww*es*ww*s*ee*s*ww*sseeee*wwnw*ww
*[*
  nnee[*ww*s*nee]ww[*ee*ww]s
  *[*ne[*w*n*se]w[*e*w]n
    [*ee*e*s*w*w*s*e*e*s*ww*wnn*n]
    s*[*nnee*s*w*es*s*s*e*ww*wnn]*s]
  n*[*
    nee[*ww*s*nee]ww[*ee*ww]s[*nne*ees*w*w*ess*w*w*n]
    s*[*
      nnnee[*ww*s*nee]ww[*ee*ww]s*[*nee*e*s*s*ss*w*w*wn*nn]
      ss*[*
        seee[*www*n*seee]www[*eee*www]n[*e*ee*s*www*n]
        s*[*
          ee[*ww*n*see]ww[*ee*ww]n*[*nnne*ee*sww*sss*e*en*wwws*n]
          s*[*
            nnne[*w*s*ne]w[*e*w]s*[*nnee*sw*s*ee*ss*w*w*wn*n]
            s*[*
              nnne[*w*s*ne]w[*e*w]s[*ne*sss*s*wnn*n]
              s*[*
                nneee[*www*s*neee]www[*eee*www]s[*ne*ees*ww*s*see*sw*w*wnn*n]
                s*[*
                  se[*w*n*se]w[*e*w]n[*eee*ssww*n*w*n]
                  s*[*
                    ne*e*ws*s*wwwwws*nn]n]]s]s]]n]]n]
  sss*[
    [*e*]*wwwww]n
*]

Bueno, en realidad esa es la versión no comentada. La versión comentada es bastante más larga [1].

Pueden verse este y otros programas en acción gracias al intérprete de Paintfuck en JavaScript, que también puede servir para quien quiera escribir sus propios programas en Paintfuck.

Referencias

[1] http://www.formauri.es/personal/pgimeno/temp/esoteric/paintfuck/decimal-counter.pfk

2010-01-17

Y más puzles

La colección de Simon Tatham está echando humo. Ahora son tres nuevos juegos más: Towers, Singles y Magnets.

Towers es un poco raro. Se trata de determinar la altura de unas torres (que son números enteros dispuestos en forma de cuadrado latino, de nuevo), una torre por casilla. Las pistas con las que contamos son unos enteros dispuestos alrededor del cuadrado, que indican el número de torres visibles horizontalmente desde el lado en el que se encuentra la pista en cuestión. Las torres más altas ocultan a las más bajas. Por ejemplo, en un casillero de 5×5, si en el lado izquierdo una de las filas tiene un 5 como pista, eso quiere decir que esa fila están los números del 1 al 5 en escala ascendente. Si pone un 3, hay muchas posibilidades y tendremos que valernos de más información para averiguarlo. Si pone un 1, entonces esa fila empieza por un 5, porque es el único que oculta a todos los demás. No me ha parecido interesante; me parece muy artificioso y poco intuitivo. Aunque eso mismo pensaba de Tents y al final sí que le vi la gracia.

Singles es algo más normal. Se nos muestra un cuadrado de n×n (no latino, esta vez) relleno con enteros de 1 a n, algunos repetidos en ciertas filas y columnas. Se trata de tachar todos los repetidos menos uno y dejar únicamente los no repetidos. Como condiciones adicionales, los números tachados no pueden estar adyacentes (arriba/abajo/izquierda/derecha, pero pueden estar en diagonal) y no puede haber grupos aislados de números sin tachar, es decir, se debe poder ir de cualquier número sin tachar a cualquier otro número mediante repetidos movimientos de una casilla cada uno hacia arriba, abajo, a la izquierda o a la derecha, o lo que es también lo mismo, los números no tachados tienen que formar un área conexa. Tiene su encanto.

Por último, en Magnets nos dan un tablero no necesariamente cuadrado, en el que se han dispuesto de antemano una serie de fichas rectangulares de 2×1. Cada una puede ser bien un imán, bien una ficha neutra. Se trata de colocar todos los imanes con su polaridad, respetando dos reglas básicas: una, que el número de signos positivos y el número de signos negativos de una fila o columna coincidan con las pistas que se nos dan (sin embargo, en algunas variantes no se nos dan todas: los que no tienen número no son cero, sino desconocidos), y otra, que no puede haber dos signos + juntos ni dos signos - juntos. Este es el más entretenido de los tres, a mi gusto.

Están todos disponibles para descarga para varias plataformas (Linux, OS X, Android, Windows, Palm) en el sitio de costumbre: http://www.chiark.greenend.org.uk/~sgtatham/puzzles/.

2010-01-13

El Wall Hugger de Robot Odyssey

Robot Odyssey es un juego educativo para adultos, sumamente interesante. Fue creado en 1984 por una compañía llamada The Learning Company e hicieron versiones para Apple II, TRS-80 e IBM PC.

La idea del juego es cablear unos robots utilizando circuitos lógicos para resolver rompecabezas. El juego se desarrolla en la ciudad imaginaria futurista de Robotropolis. El objetivo es abrirnos camino a través de las múltiples pantallas con ayuda de tres robots, que más adelante pueden ser cuatro si resolvemos un puzle extra. Los robots cuentan con cuatro detectores de paredes o bumpers, uno en cada dirección, que activan entradas cuando están en contacto con una pared; cuatro propulsores, también uno por dirección, que son activados por salidas; una pinza que tiene una entrada indicadora de que ha cogido algo y una salida con la que le damos la orden de activarse o no, y una antena para comunicarse con los otros robots, con su entrada y su salida. Además hay un interruptor de encendido/apagado, una batería que se va gastando mientras el robot está conectado y un «periscopio» por si queremos ver el exterior mientras el robot se mueve con el jugador en su interior. Las puertas lógicas con que programamos nuestros robots tienen un retardo de propagación de una unidad de tiempo, lo cual tiene que ser tenido en cuenta en algunos diseños.

Pantalla inicial de Robot Odyssey
Pantalla inicial de Robot Odyssey, donde nos encontramos por primera vez a los tres robots que nos ayudarán en la aventura (aquí vemos la versión para Apple II).

Para superar ciertas pantallas, por ejemplo, hay que conseguir que los robots activen sus pinzas en ciertos momentos, para coger un objeto al que no podemos acceder porque un robot centinela impide el paso a humanos. En otras, la estructura de la pantalla es lo bastante sencilla como para que, con un poco de imaginación, podamos diseñar un circuito sencillo para resolverla. Por supuesto, a medida que avanzamos pantallas aumenta la dificultad y pronto necesitamos más de un robot actuando coordinadamente para resolver ciertos puzles.

A. K. Dewdney ya habló de este juego en su sección Juegos de Ordenador de la revista Investigación y ciencia. Cuando leí el artículo, se me caía la baba y me quedé con unas ganas tremendas de verlo. Hoy, gracias a las maravillas del software libre e internet, existe una versión rehecha en Java llamada DroidQuest, disponible para descarga, escrita por Thomas Foote, en http://www.droidquest.com/. Por añadidura, el autor también ofrece la versión original de Apple II para descarga, así que quien disponga de un emulador puede también experimentar la sensación de jugar al juego original tal y como Dewdney lo mostró en su sección. Huelga decir que no lo solté hasta completarlo, superando así esa «cuenta pendiente».

Una característica interesante del juego es que hay unos chips disponibles, unos circuitos integrados que podemos programar para combinar varias operaciones en un solo circuito, simplificando con ello los diseños y ahorrando así puertas lógicas, lo cual es más interesante si tenemos en cuenta que hay un número limitado de ellas disponible. Algunos de los chips vienen ya preprogramados.

Interior de uno de los robots, con el chip Wallhugger preprogramado conectado.
Interior de uno de los robots, con un cableado predefinido que incluye un chip preprogramado, en este caso el chip Wallhugger. También está a la vista uno de los objetos del juego, una llave.

El Wallhugger en particular es un chip que, al cablearlo como se ve en la figura, consigue que el robot vaya pegado a las paredes de una habitación, recorriéndolas en sentido antihorario. Tiene algunas limitaciones y, debido a ellas, en el juego tenemos pocas ocasiones para usarlo, pero su interés radica en la dificultad de su elaboración. De acuerdo con la documentación, el chip contiene 16 puertas lógicas y un chip más en su interior. El autor de DroidQuest dice en una página dedicada al chip:

El chip Wallhugger parece ser el Santo Grial del Robot Odyssey. De acuerdo con el juego original, fue diseñado con «16 puertas lógicas y un chip anidado». No tengo ni idea de cómo el Wallhugger fue creado solo con eso. Me encantaría averiguar cómo funciona. [1]

A mí también me dejó con el gusanillo, pero como siempre he sido de naturaleza curiosa, finalmente agarré el original de la versión de Apple y me puse a destriparlo.

El proceso requirió bastantes pasos. Primero, tenía que averiguar en qué posiciones del archivo .dsk se guardaban los datos de los chips. En esta parte encontré tanto facilidades como dificultades que lo hicieron laborioso, pero básicamente rutinario. Lo siguiente era realizar la ingeniería inversa del formato con el que se almacenan los circuitos del chip.

Esta parte fue, por supuesto, la más interesante. Mediante la creación de diversos chips, averigüé cómo se codificaban las entradas y salidas del chip, así como las puertas empleadas. Cuando alcancé una comprensión aceptable del formato, me lancé en pos del Wallhugger.

De esa manera, constaté que lo que decía la documentación era perfectamente correcto: efectivamente, en su interior contenía 16 puertas lógicas y un chip anidado. Aquí está el circuito principal, dibujado con el programa libre de diseño y simulación de circuitos TkGate (sí, ya sé que pronunciado en español suena muy mal), concretamente con la versión 1.8:

Esquema del circuito principal del chip Wallhugger
Esquema del circuito principal del chip Wallhugger (clic para ampliar)

Y a continuación, el esquema del chip anidado:

Esquema del chip anidado dentro del chip Wallhugger
Esquema del chip anidado dentro del chip Wallhugger (clic para ampliar). En los flip-flops (FF) no está dibujada la salida derecha. Los LEDs a la salida de los flip-flops están solo como referencia.

Para poder realizar la simulación y probar el diseño en funcionamiento, tuve que crear un flip-flop R-S en TkGate que fuera compatible con el de Robot Odyssey. La idea era que cuando ambas entradas tuvieran un 1 lógico simultáneamente, el estado no variara, pues es la forma en que se comporta el RO. Aquí está el diseño que empleé:

Esquema del flip-flop usado para la simulación con TkGate
Esquema del flip-flop usado para la simulación con TkGate (clic para ampliar)

¿Cuál es el principio de funcionamiento de este curioso chip? Lo primero que hay que observar es que, si conectamos el bumper izquierdo al propulsor superior, el bumper superior al propulsor derecho, el bumper derecho al propulsor inferior, y el bumper inferior al propulsor izquierdo, tendremos un robot que casi funciona, pues al menos es capaz de moverse en círculos en habitaciones con paredes convexas. El problema radica en que cuando nuestro robot recorre una pared con un ángulo cóncavo (de 270°), al terminarse ésta pierde el contacto y deja de propulsarse, quedándose parado. El chip incorpora la circuitería necesaria para actuar en ese caso y resolver el inconveniente.

Efectivamente, los cuatro bumpers están conectados a los cuatro propulsores a través de sendas puertas OR, es decir, que mientras la otra entrada de cada una de las puertas OR sea cero, nuestro robot se comportará igual que el robot seguidor de paredes convexas recién descrito.

Ahora, ¿cuándo ha de actuar y qué ha de hacer para poder salvar también ángulos cóncavos? Si el problema es que se queda parado, lógicamente lo que tendrá que hacer es moverse. La condición es simplemente que no haya ningún bumper activo, que es lo que provoca que nuestro seguidor de paredes convexas se pare. Esa condición es detectada por las tres puertas OR en cascada de la parte superior que van seguidas de un inversor. Cuando la salida del inversor se activa, quiere decir que no hay ningún bumper tocando una pared. Con esto se activan cuatro puertas AND que dan paso a la señal que moverá el robot. Veamos cómo.

Ahora que sabemos que en ese caso hay que moverse, queda la duda de hacia adónde. Puesto que se trata de continuar siguiendo la pared de la esquina que acabamos de dejar, habrá que moverse hacia ella. Nos interesa que el siguiente bumper entre en contacto con la siguiente pared, para que la parte seguidora de paredes convexas pueda seguir actuando. Por suerte, gracias a los retardos de propagación de las puertas, tras perderse el contacto con la pared anterior el propulsor habrá estado en marcha el tiempo suficiente como para que el robot haya sobrepasado la esquina, habiendo recorrido la distancia suficiente como para que, si vamos directamente 45° en diagonal en dirección a la esquina que acabamos de dejar, acabemos tocando la nueva pared y no la antigua de la que venimos.

Por tanto, se trata de moverse en diagonal hacia la esquina que acabamos de dejar. ¿Cómo conseguimos eso? Ahí es donde entra en juego el chip anidado.

El esquema de este chip está diseñado de la siguiente forma. Hay cuatro flip-flops, cuatro entradas y cuatro salidas. Las cuatro entradas vienen directamente de los bumpers. Cada bumper activa un flip-flop y pone a cero los otros tres (si no hay conflictos, claro). Es decir, el set del primer flip-flop viene del primer bumper y el reset es el OR de los otros tres, y lo mismo con los demás. En resumen, el chip está diseñado para recordar cuál fue el último bumper activo. Cuando estamos tratando de doblar una esquina de 270° y perdemos el contacto, tenemos la garantía (o eso presumimos) de que en el último instante justo antes de perderse el contacto solo había un bumper activo, por lo tanto no hay que preocuparse de los conflictos. (Cuando hay paredes muy próximas, esto podría no cumplirse, y esa es una de las limitaciones de Wallhugger: debe tener suficiente espacio para moverse sin que, por ejemplo, dos bumpers opuestos toquen dos paredes a la vez).

La línea de puesta a uno de cada flip-flop es retardada mediante tres puertas OR, por un motivo que no he llegado a entender. Quizá sea porque de lo contrario, pulsos muy cortos del bumper podrían perderse antes de que la señal de puesta a cero de otro bumper la desactive, aunque no le acabo de ver el sentido. Parece, en cualquier caso, que el número de retardos es uno más que los que se producen en la señal reset, por lo que la intención parece en todo caso que el set llegue siempre en último lugar.

Tenemos entonces un chip que recuerda el último bumper activo antes de perderse el contacto y queremos usarlo para, cuando se pierde el contacto, movernos hacia la esquina que queremos doblar. Veamos cómo. Si el bumper derecho era el último activo cuando se perdió el contacto, entonces estaba en marcha el propulsor inferior, por tanto la esquina que acabamos de dejar queda debajo y a la derecha del robot, y es hacia ahí donde queremos movernos, por lo cual tendremos que activar los propulsores izquierdo y superior. Extendiendo el razonamiento a las cuatro direcciones, el bumper superior activará los propulsores inferior e izquierdo, el izquierdo los propulsores inferior y derecho, y el inferior los propulsores derecho y superior.

Visto desde el lado de los propulsores, en ausencia de señal de bumpers, el izquierdo se activará cuando el último bumper activo fue el superior OR el derecho, etcétera. Esto justifica las cuatro puertas OR restantes, lo que concluye la totalidad del chip.

Si alguien quiere conocer el formato de los chips del Robot Odyssey y la forma de almacenarse en los archivos .dsk, aquí hay un enlace donde pueden consultarlo (en inglés): [2]. Está en inglés porque lo escribí para los miembros del grupo de Yahoo de DroidQuest. También incluye una explicación del funcionamiento, aunque más somera que la dada aquí, y el archivo TkGate con los esquemas aquí presentados listos para usar en la simulación. Aviso de que el enlace está en un directorio temporal, que puede ser movido cuando actualice mi página personal y lo coloque en la que será su ubicación definitiva. Cuando así lo haga, procuraré recordar actualizar esta entrada en consonancia, pero si alguien enlaza a ese directorio temporal directamente, debe tenerlo en cuenta.

Referencias

[1] http://mysite.verizon.net/thomasfoote/DQ/id60.htm
[2] http://www.formauri.es/personal/pgimeno/temp/RO/wallhugger.php

2010-01-03

Autómatas celulares

Es un tema tan fascinante como inevitable. Como siempre habrá lectores que no hayan oído hablar del tema, este artículo será la preceptiva introducción.

Un autómata celular consiste en un casillero en el que cada casilla (también llamada celda o célula) puede estar en un estado determinado, y una regla de transición que determina cuál será el próximo estado de cada casilla en función de su estado actual y del estado de las casillas vecinas. No está limitado a retículas cuadriculadas ni bidimensionales, pero son las más comunes. Así, los píxels de una pantalla pueden servir para representar un autómata celular, representando el estado de cada casilla como el color de un píxel (o varios, si hacemos zoom). Normalmente se parte de un casillero previamente relleno de alguna forma, ya que los casilleros en que todas las casillas tienen el mismo estado suelen ser muy monótonos.

En los autómatas celulares, es importante que toda la transición del estado suceda «de golpe», esto es, para programarlo debemos tener en cuenta que no podemos modificar el estado de una celda y después usar la versión modificada como vecina de la siguiente para calcular su estado, sino que la vecina debe tomar el estado original. Una forma sencilla de implementar esta regla es usar una matriz con el mismo tamaño que la matriz donde guardamos los estados e ir depositando los nuevos estados en esa otra matriz. Cuando acabamos de calcularlos todos, trasladamos los nuevos estados a la matriz original y/o a la pantalla. A cada transición de estados se le suele llamar «tick» o «tic», porque es como el tic-tac de un reloj figurado. También se emplea el término «generación» en el mismo sentido, como si las casillas o células fueran organismos que van teniendo descendencia.

Los autómatas celulares lineales (de una dimensión) se suelen dibujar en dos dimensiones, usando la segunda de histórico. Esto es, en cada línea se dibuja el estado completo de todas las casillas, en la inmediatamente inferior se dibuja el tick siguiente, y así sucesivamente.

Las reglas de transición pueden ser cualesquiera que tengan en cuenta las casillas vecinas. Hay quien no considera autómatas celulares los que tienen reglas asimétricas, es decir, las que producen resultados diferentes según la orientación en la que esté el dibujo original. Lo sean o no, hay conjuntos de reglas asimétricas interesantes, aunque no las vamos a tratar aquí, al menos por ahora. Hay algunos casos de autómatas en los que se analizan bloques completos de varias casillas a la vez, produciendo cambios simultáneos en varias casillas a la vez. De nuevo, hay quien no los considera autómatas per se, pero también son interesantes.

Los casos más comunes de reglas de transición son los que se rigen por el estado de las cuatro (arriba, abajo, izquierda, derecha) u ocho (incluyendo diagonales) casillas vecinas a una dada, a veces incluyendo a la casilla misma, en una retícula cuadriculada. Entre los autómatas de dos estados, es común contar el número de casillas vecinas que hay en uno de dichos estados y determinar el siguiente en función de dicho número.

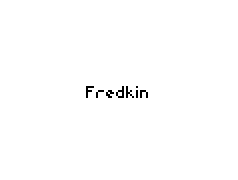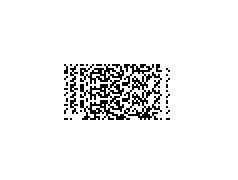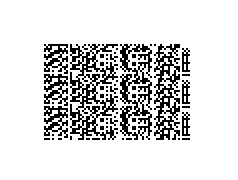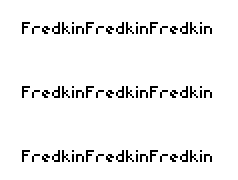
Veamos un par de ejemplos. El autómata de Edward Fredkin considera un entorno de nueve casillas y la regla de transición es la siguiente: el nuevo estado será un 1 si el estado actual es 1 y el número de casillas que rodean a la actual que están en estado 1 es par, o bien si está a 0 y el número de casillas que estan a 1 es impar; será 0 en caso contrario. La regla equivale a sumar los valores de las nueve casillas incluyendo la central, asignando un 1 si la suma es impar y 0 si no lo es. Curiosamente, con esta regla, cada figura acaba multiplicada por 9 al cabo de unos cuantos ticks. Aquí vemos el estado inicial y 32 estados posteriores del autómata de Fredkin:

Autómata de Fredkin en movimiento
Autómata de Fredkin en acción, tomando como estado inicial un rótulo con la palabra Fredkin. Al cabo de 32 iteraciones, se ha multiplicado por 9.

El otro ejemplo que vamos a considerar es el llamado Juego de la vida de J.H. Conway. La regla de transición es: si una célula está «muerta» (estado 0), estará «viva» (estado 1) en la generación siguiente si tiene a su alrededor (sin contarse a sí misma) exactamente tres casillas «vivas». Si está «viva», entonces estará «viva» en la próxima generación únicamente si tiene dos o tres vecinas «vivas». En otro caso, «morirá». Esto se suele indicar con la notación B3/S23 (la B, de Born, indica el número de vecinos necesario para que la casilla pase a estado 1 cuando es 0, en este caso 3, y la S, de Survive, el número de vecinos necesario para que la casilla pase a estado 1 cuando es 1, en este caso 2 y 3).

Con esas sencillas reglas basta para que se plantee todo un abanico de cuestiones con respuestas complicadas. Típicamente, a partir de una configuración cualquiera al azar no muy grande, la población fluctúa durante bastantes generaciones y termina en un estado estable en el que se ven patrones estáticos y otros oscilantes con periodo 2, y ocasionalmente algún otro. Por ejemplo, la siguiente configuración:

Palabra «Conway» que se someterá al Juego de la Vida

que tiene inicialmente 58 celdas «vivas», tras 1.235 generaciones evoluciona a la siguiente figura (clic para versión completa):

Estado final estable del desarrollo de la palabra «Conway»

con una «población» de 228 celdas que ya permanece constante durante el resto de generaciones. En el curso de esas 1.235 generaciones, ha liberado cuatro «deslizadores». Un deslizador es una configuración cíclica que va cambiando de manera que tras cierto número de generaciones, se repite la misma forma pero está desplazada. El más común, en cuanto a que aparece espontáneamente con facilidad, es este de cuatro estados y que en todo momento tiene cinco células «vivas»:

Deslizador típico en el Juego de la Vida

Por supuesto, puede aparecer en cualquier posición, ya que el Juego de la Vida es simétrico. Obsérvese cómo tras cuatro generaciones, tiene la misma forma original pero está una casilla desplazado, hacia arriba y hacia la derecha en este caso.

Esta tendencia de las configuraciones al azar a alcanzar la estabilidad poblacional con el tiempo, le hizo a Conway conjeturar que no existía ninguna configuración que creciera indefinidamente, y ofreció un premio de 50 dólares a quien encontrara una que lo hiciera. El premio fue ganado por Bill Gosper, quien encontró una configuración cíclica que emitía un deslizador cada 30 generaciones y, por tanto, la población del conjunto siempre crecía, demostrando así falsa la conjetura de Conway. El cañón lanza-deslizadores, como se le conoció, tenía este aspecto:

Cañón lanza-deslizadores de Bill Gosper
Cañón lanza-deslizadores de Bill Gosper, en pleno proceso (se muestran dos deslizadores ya generados).

Hoy en día se conocen muchas configuraciones que crecen siempre. También se sabe que el Juego de la Vida es Turing-completo, es decir, que es posible crear una configuración tal que emule cualquier cálculo que un ordenador es capaz de realizar (otra cosa es la velocidad). El Juego de la Vida ha sido profusamente estudiado y hay muchas webs recomendables a quien quiera profundizar sobre él; valgan como ejemplo [1] (un léxico) y [2] (la entrada de la Wikipedia inglesa sobre este autómata).

Hay otro tipo de regla que tiene como caso particular el Juego de la Vida. Se trata de Generations. La idea es la misma, pero en lugar de morir inmediatamente, las células se hacen «viejas». Para definir la regla hace falta especificar, además de los supervivientes y neonatos, el número total de estados del autómata. Por ejemplo, 345/2/4 indica que hay cuatro estados. Si una célula está en el estado 1 y el número de células vecinas de una dada, sin contar ella misma, en el estado 1 es de 3, 4 ó 5, entonces esa celda continuará en el estado 1 en el siguiente tick. Si está en el estado 0 y está rodeada exactamente de dos células en el estado 1, entonces pasará al estado 1. En cualquier otro caso, si su estado es 1 pasará a ser 2 (envejecerá). Si es 2, independientemente de las células que la rodeen, pasará a 3 en el tick siguiente, y si es 3, pasará a 0 (muerte final). Si ya era 0, se quedará igual. La regla recién descrita recibe el nombre de Star Wars y fue creada por Mirek Wojtowicz. Obviamente, el Juego de la Vida se escribiría 23/3/2 en notación Generations. El autómata de Fredkin se escribiría 02468/1357/2 en esta notación.

La regla /2/3 de Generations es digna de mención. Tiene tres estados; toda célula en el estado 1 pasará a 2 en la generación siguiente, ya que no hay indicación de ningún número de estados con el que sobrevivir (mantenerse en 1), y después a 0. Si una célula muerta está rodeada de dos células en estado 1, pasará al estado 1 en la próxima generación. Al autómata recién descrito se le llama Brian's Brain, descubierto por Brian Silverman, y es muy entretenido contemplarlo cual si se tratara de una pecera. Aquí hay una versión animada, cortesía de Wikipedia: [3].

Por supuesto, Generations no es la única familia de reglas existente. Hay un autómata celular llamado Wireworld, descubierto también por Silverman, que modela el comportamiento de los circuitos electrónicos. Sus reglas, aun siendo muy parecidas a las de Generations, contienen un estado extra que permanece siempre inmutable. Digamos que es un Generations con máscara.

Así, Wireworld es un conjunto de reglas con cuatro estados. El primer estado, el 0, permanece siempre inalterado. Al estado 1 se le llama «cable». Al estado 2 se le llama «cabeza de electrón», y al 3 «cola de electrón». Las reglas son las siguientes: si una célula cable tiene a su alrededor exactamente 1 ó 2 cabezas de electrón, entonces pasará a ser cabeza de electrón en la generación siguiente; de lo contrario permanecerá cable. La cabeza de electrón pasará siempre a ser cola de electrón, y la cola de electrón pasará siempre a ser cable. Es, por tanto, el equivalente a la regla /12/3 en Generations, con la adición de un estado inmutable.

Hay otros juegos de reglas en los que se realizan operaciones aritméticas con los estados. Uno de los más llamativos es la máquina Hodge Podge (que fue traducida por la revista Investigación y Ciencia como «máquina batiburrillo»), diseñada por M. Gerhard y H. Schuster. Pese a que se le llame máquina, es un autómata celular. En realidad, es toda una familia de reglas, ya que se rigen por cuatro parámetros: el número de estados y varios «niveles de infección». Si n es el número de estados, se define una célula como «sana» si está en el estado 0, como «enferma» si está en el estado n-1, y como «infectada» si está en cualquiera de los estados intermedios. La regla para una célula «sana» es pasar a un estado dado por ⌊E/re⌋ + ⌊I/ri⌋, donde ⌊x⌋ indica la parte entera de x, E es el número de células enfermas que rodean a la actual, e I es el número de células infectadas. re y ri son dos de los parámetros que definen el autómata.

Para una célula «infectada», la regla es la siguiente: su próximo estado será la parte entera de la media de los estados de las células infectadas que la rodean incluyéndose a sí misma, más un parámetro de infección g. El valor se trunca para que no exceda de n-1. La regla para una célula «enferma» es la más sencilla: pasará siempre al estado «sana» en la siguiente generación. Los cuatro parámetros son, pues, n (número de estados), re (relación de infección para células enfermas), ri (relación de infección para células infectadas) y g (velocidad de progreso de la enfermedad). Esos parámetros, junto con el tipo de entorno, que no necesariamente es de ocho células, determinan una máquina concreta.

Pese a lo complicado de las reglas, es todo un placer verlas actuar, generando unos bellos patrones en espiral característicos de una reacción catalítica heterogénea (el autómata fue diseñado con el fin de emular dicha reacción). Aquí hay una versión en Flash: [4]. Hace falta algo de paciencia para ver las espirales formarse; a veces se desvanecen antes de cobrar fuerza. Aquí se ilustran versiones ya desarrolladas de patrones al azar usando diferentes entornos: [5]

Hay muchos otros conjuntos de reglas posibles, pero no vamos a detenernos en más. En vez de eso, vamos a presentar dos programas que reconocen muchos juegos de reglas y nos permiten dibujar patrones iniciales o probar patrones al azar. Uno de ellos es Mirek's Java Cellebration, MJCell (versión 1.51 a fecha de escritura de este artículo), escrito en Java, como su nombre indica, que es una versión del Mirek's Cellebration (MCell) para Windows. Una ventaja de la versión Java es que se puede ejecutar en línea; otra, que el código fuente está disponible, aunque la licencia es incierta. El otro programa es Golly, con unos pocos algoritmos y patrones menos que MJCell, pero con una velocidad realmente pasmosa. Golly hace uso de un algoritmo que utiliza tablas «hash» para reconocer patrones ya visitados, y hacerlos evolucionar a muchas veces la velocidad normal. Las tablas requieren gran cantidad de memoria para conseguir su velocidad; he llegado a llenar los 3 Gb de memoria que permiten las aplicaciones de 32 bits en Linux (algún día antes de 2038 migraré mi Debian a 64 bits, ¡lo prometo!). Esa memoria sólo hace falta para conseguir la velocidad máxima, pero no hace falta tanta para ver los patrones a una velocidad de vértigo, pudiendo ver pasar literalmente trillones de generaciones en segundos para autómatas simples, o miles de millones en minutos para otros no tan simples. Por ejemplo, podemos ver recrearse la Esfinge de William R. Buckley, una máquina autorreplicante basada en el complejo autómata original de 29 estados de John von Neumann, al que lleva unos 40 minutos completar las 261.903.042.739 generaciones que requiere construir una copia e insuflarle vida. O podemos ver la computadora de primos diseñada en Wireworld de Mark Owen, mostrando primo tras primo en su flamante display. O podemos ver en funcionamiento la máquina de Turing de tres estados de Paul Rendell, implementada mediante un patrón del Juego de la Vida.

Otra ventaja de Golly en comparación con MJCell es su universo virtualmente ilimitado. En MJCell hemos de definir de antemano el tamaño de la cuadrícula y no se le dan bien las cuadrículas muy grandes, pero en Golly, los patrones se extienden «hasta el infinito y más allá», por lo que no tenemos que sufrir por si el patrón llega al borde. La licencia es GPL y está también disponible en versión binaria para Linux, Mac y Windows.

Referencias

[1] http://www.bitstorm.org/gameoflife/lexicon/
[2] http://en.wikipedia.org/wiki/Conway's_Game_of_Life
[3] http://upload.wikimedia.org/wikipedia/en/a/a7/Brian's_brain.gif
[4] http://www.galaxygoo.org/blogs/2006/07/hodgepodge_machine.html
[5] http://www.vbaccelerator.com/home/VB/Code/vbMedia/Algorithmic_Images/Hodge_Podge/article.asp

2009-12-29

Lenguajes esotéricos

Este artículo es una reedición, con algunos extras nuevos, del que publiqué en la columna Informática recreativa en la ahora extinta web de Lola Cárdenas El rincón del programador. También fue publicada con mi permiso en programacion.com. Pido disculpas si algunos enlaces no funcionan. También pido disculpas por el uso repetido de la palabra decrementar a lo largo del texto, no reconocida en el DRAE.


Ser aficionado a la informática y no saber programar es algo que no casa bien. Un auténtico aficionado sabrá al menos hacer pinitos en algún lenguaje de programación, sea Java, Basic, Pascal, C o cualquier otro. Entre los lenguajes de programación también hay modas; un cierto lenguaje «se lleva» más que otros en ciertos momentos, lo cual es lógico habida cuenta de que la informática evoluciona y con ella las necesidades.

No muchos conocen, sin embargo, la inmensa variedad de lenguajes de programación que hay disponibles. Los nombres que ahora mismo me vienen a la cabeza sin consultar ninguna fuente de información son COBOL, ALGOL, APL, BASIC, RPG, Forth, Fortran, Lisp, PL/I, Logo, C, Pascal, Perl, Python, TCL, Ada, Java, ensamblador... y he omitido deliberadamente nombrar variantes como Visual Basic, RPG III, Scheme (un derivado de Lisp), C++ o Delphi (un Pascal ampliado).

Cuando llegamos al ensamblador, el tema de las variantes se convierte en locura. Cada modelo de microprocesador tiene su propio ensamblador, y existen miles y miles de modelos: Z80, PIC-16, 8051, 8086, 6809, 68000, 6502... A veces, como en el caso del 80x86 de Intel, hay varios, incluso multitud de dialectos: el dialecto oficial de Intel, el dialecto oficial del proyecto GNU (formato AT&T), el dialecto del ensamblador gratuito NASM...

Para liar aún más la madeja existen personas que inventan su propio lenguaje ensamblador, el de un procesador que no existe. El ejemplo más notable quizá sea el de Donald Ervin Knuth, matemático y escritor de una serie de tratados sobre computación famosos en todo el mundo. Existen simuladores de los dos lenguajes ensambladores que ha inventado, que corresponden a los procesadores imaginarios llamados MIX y MMIX.

Ahí no queda todo. Hay gente que no ve razón en que el lenguaje a inventar sea un lenguaje ensamblador; simplemente inventan un lenguaje nuevo. Las razones son muy variadas; está claro por ejemplo que Sun Microsystems tenía razones poderosas para inventar el Java. Pero no todo el mundo necesita razones poderosas; aquí vamos a tratar precisamente sobre los lenguajes de programación que han sido inventados por puro entretenimiento. ¿Hay gente capaz de eso? Sí, y no pocos. Incluso existen intérpretes de la mayoría de esos lenguajes, y en algunos casos hasta compiladores.

Uno de los primeros lenguajes esotéricos (al menos que yo tenga referencia, pues fue creado en 1972), y quizá de los más extendidos, es el INTERCAL. Su diseño se fundamenta en la pretensión de crear un lenguaje totalmente distinto a cualquier otro en todo, aunque sin olvidar desde luego el sentido del humor. En él, tenemos que pedir por favor la ejecución de ciertas sentencias; en lugar del conocido «go to» (ir a) para saltar a otra instrucción, tenemos que escribir «come from» (venir desde) en el lugar de destino, aunque esto es una extensión posterior a la primera especificación. Podemos pedir que se abstenga de ejecutar ciertas sentencias, por ejemplo: PLEASE ABSTAIN FROM CALCULATING evita que se ejecute la orden CALCULATE. Cuando llegamos al capítulo sobre la precedencia de operadores se nos explica que no la hay, porque precisamente el objetivo en el diseño del lenguaje era que no hubiera ningún precedente. Como resultado de esta regla, cuando necesitamos concatenar dos operaciones juntas hay que agrupar los operandos por pares mediante un equivalente a los paréntesis. El nombre completo del lenguaje, según los autores, es «Lenguaje Compilado Carente de Acrónimo Pronunciable», cuya abreviatura es, «por razones obvias», INTERCAL. Podemos ver el aspecto que tiene un programa escrito en INTERCAL en la figura 1. La función de este programa, extraído del manual de INTERCAL, es leer dos enteros de 32 bits, tratándolos como enteros con signo en formato de complemento a dos, y escribir su valor absoluto.

        DO (5) NEXT
    (5) DO FORGET #1
        PLEASE WRITE IN :1
        DO .1 <- 'V":1~'#32768$#0'"$#1'~#3
        DO (1) NEXT
        DO :1 <- "'V":1~'#65535$#0'"$#65535'
                ~'#0$#65535'"$"'V":1~'#0$#65535'"
                $#65535'~'#0$#65535'"
        DO :2 <- #1
        PLEASE DO (4) NEXT
    (4) DO FORGET #1
        DO .1 <- "'V":1~'#65535$#0'"$":2~'#65535
                $#0'"'~'#0$#65535'"$"'V":1~'#0
                $#65535'"$":2~'#65535$#0'"'~'#0$#65535'"
        DO (1) NEXT
        DO :2 <- ":2~'#0$#65535'"
                $"'":2~'#65535$#0'"$#0'~'#32767$#1'"
        DO (4) NEXT
    (2) DO RESUME .1
    (1) PLEASE DO (2) NEXT
        PLEASE FORGET #1
        DO READ OUT :1
        PLEASE DO .1 <- 'V"':1~:1'~#1"$#1'~#3
        DO (3) NEXT
        PLEASE DO (5) NEXT
    (3) DO (2) NEXT
        PLEASE GIVE UP
Figura 1: Programa en lenguaje INTERCAL

Los programas en INTERCAL, desde luego, no son fáciles de escribir. De todas formas no es el lenguaje esotérico en el que más cuesta escribir un programa. Por ejemplo, en lenguaje Piet es imposible escribir un programa: hay que dibujarlo. Vemos en la figura 2 un ejemplo de un programa en lenguaje Piet.
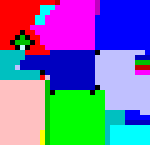
Figura 2: Programa en lenguaje Piet
Figura 2: Programa en lenguaje Piet.

El programa de la figura 2 se limita a escribir la conocida frase «Hello, world!» («¡Hola, mundo!»). Hay que reconocer, sin embargo, que hemos hecho abuso del significado de la palabra escribir en este contexto. Diseñar el programa es algo que en Piet no es una tarea demasiado difícil.

Quien busque algo en lo que sea verdaderamente difícil programar, puede intentar usar Malbolge. El nombre procede del Malebolge (el octavo círculo del infierno de Dante), aunque seguramente el nombre fue recortado a causa de una limitación del sistema operativo para el que fue originariamente escrito (MS-DOS), que limita la longitud de los nombres a ocho caracteres. Esta alusión al infierno puede dar una somera idea de la complicación del lenguaje, aunque obtendremos una idea más aproximada conociendo la dificultad que supuso para Andrew Cooke escribir un programa en Malbolge que simplemente escribiera «Hello, world» (digamos que lo hizo por métodos de tipo «ensayo y error», y ni siquiera consiguió uniformidad en las mayúsculas y minúsculas ni signos de puntuación: el programa escribía «HEllO WORld»). En la figura 3 vemos el programa que consiguió la hazaña.

(=<`$9]7<5YXz7wT.3,+O/o'K%$H"'~D|#z@b=`{^Lx8%$Xmrkpohm-kNi;g
sedcba`_^]\[ZYXWVUTSRQPONMLKJIHGFEDCBA@?>=<;:9876543s+O<oLm
Figura 3: Programa en lenguaje Malbolge.

No hay que desesperarse por no entender nada. Esa es justo la intención que el inventor del lenguaje tenía. De hecho, el cripticismo buscado por el autor le resta cierto interés al lenguaje: está deliberadamente encriptado, razón por la cual Cooke propone un «Malbolge normalizado», que es lo que queda después de la fase de desencriptación. No hay que dejarse llevar por la idea, sin embargo, de que esto le reste dificultad al lenguaje. Se puede (si es que se puede) escribir un programa en Malbolge normalizado y después aplicar la fase final de encriptación para obtener un programa válido en Malbolge. La figura 4 muestra el aspecto del programa «Hello world» en Malbolge normalizado.

jpp<jp<pop<<jo*<popp<o*p<pp<pop<pop<jijoj/o<vvjpopoopo<ojo/o
vooooooooooooooooooooooooooooooooooooooooooooooooooo*p<v*<*
Figura 4: Programa en lenguaje Malbolge normalizado.

Aunque resulta algo más legible que antes, sigue siendo complicado de descifrar sin una descripción de qué significa cada símbolo (y aun con ella). En el fichero de la distribución de Malbolge existe una descripción completa del lenguaje.

Pero de entre todos los lenguajes esotéricos hay uno que llama la atención por su exquisita simplicidad y potencia. Se llama Brainfuck, que en inglés suena tan mal como en español su traducción de Jodecerebros, con perdón. Debido a lo ofensivo del nombre, no es tan fácil buscar referencias en WWW usando buscadores ya que hay muchas variaciones del nombre para ocultar su carácter ofensivo: Brainf*ck, Brainf***, Brainfsck, BF... La intención de su creador, Urban Müller, era la de crear un lenguaje para el cual se pudiera escribir el compilador más corto del mundo.

A pesar del nombre, escribir un programa en Brainfuck no es tan difícil como cabe pensar. Está demostrado que es un lenguaje Turing-completo, lo que expresado de forma simple significa que se puede codificar cualquier algoritmo con él. Existen únicamente ocho instrucciones, cada una de las cuales está asociada a un símbolo. Hay un resumen en la tabla 1. Existe un puntero de programa, que representa la posición en la que se está ejecutando actualmente el código, como en cualquier otro lenguaje imperativo (con algunas salvedades), y un puntero de datos, que es una característica propia de Brainfuck y que sirve precisamente para manipular los datos. El puntero de datos apunta a la posición cero de una zona de memoria, inicialimente rellena de ceros. No se considera correcto un programa si intenta aplicar un decremento al puntero de datos cuando éste está en la posición cero. Usualmente se considera que el contenido de cada posición de memoria es un byte sin signo (un número de 0 a 255). Al incrementar uno de estos bytes cuando su valor era 255, generalmente pasa a valer 0. Al aplicarle un decremento cuando su valor era 0, generalmente pasa a valer 255. Decimos «generalmente» porque según la implementación puede haber versiones del lenguaje que adopten otros convenios.

Instrucción Descripción Equivalente C
- Restar 1 al contenido de la celda de memoria actualmente apuntada por el puntero de datos. --*p;
+ Sumar 1 al contenido de la celda de memoria actualmente apuntada por el puntero de datos. ++*p;
< Decrementar el puntero de datos en una unidad. Es un error ejecutar esta instrucción cuando el puntero de datos tiene el valor 0. --p;
> Incrementar el puntero de datos en una unidad. ++p;
[ Si el contenido de la celda de memoria a la que apunta el puntero de datos es cero, buscar el correspondiente «]» y colocar el puntero de instrucción inmediatamente después. Es posible anidarlos. No se considera un programa válido aquél en el que no hay un balance correcto entre los «[» y los «]». while(*p){
] Colocar el puntero de programa en el «[» anterior correspondiente. }
, Introducir un carácter desde entrada estándar y colocarlo en la celda apuntada por el valor actual del puntero de datos. *p=getchar();
. Escribir el carácter ASCII correspondiente al valor de la celda actual en la salida estándar. putchar(*p);
Tabla 1: Instrucciones del lenguaje Brainfuck.

Aquellos que sepan C pueden valerse de las equivalencias aproximadas que se dan en la tabla para entender un poco mejor las acciones que cada instrucción realiza. Con tal sencillez estructural, mal puede sorprendernos la facilidad con la que se puede escribir un intérprete, y hasta un compilador de Brainfuck. Pero antes de entrar en detalles respecto al intérprete, analizaremos un poco el lenguaje y veremos algunas construcciones comunes.

Por ejemplo, la secuencia de instrucciones [-] se usa a menudo en los programas Brainfuck, y sirve para poner a cero la celda de memoria actual: equivale en C a la instrucción «while(*p){--*p;}», es decir, mientras la celda de memoria actual sea distinta de cero, decrementarla, lo cual obviamente tiene como efecto ponerla a cero.

Si queremos mover el valor actual una posición a la derecha (aquí entendemos que «izquierda» implica disminuir el puntero de datos y «derecha» aumentarlo), utilizaremos el siguiente programa: [>+<-]. Esto va incrementando el byte de la derecha de la posición inicial y decrementando el actual, hasta que éste es cero. Como resultado, al byte situado a la derecha de la posición inicial se le suma lo que hubiera en dicha posición, que acaba siendo cero. Suponiendo que a la derecha hubiera un cero, habremos acabado moviendo el byte de esa posición un lugar a la derecha. Copiar un valor es un problema más complicado; asumiendo que las dos posiciones situadas a la derecha de la actual sean cero, se procederá de la siguiente forma: primero, usaremos [>+>+<<-], que tendrá el efecto de copiar el valor en la posición actual a la posición de su derecha y a la siguiente más a la derecha, y poner a cero la posición actual; después iremos dos posiciones a la derecha usando >>, tras lo cual usaremos una versión modificada del fragmento mover: [<<+>>-], es decir, mover el byte de la posición p (siendo p la posición del puntero de datos) a la posición p-2. Al terminar, retrocederemos otra vez dos posiciones usando <<, aunque dependiendo de la aplicación que queramos darle este último paso puede ser innecesario.

Si no estamos seguros de si están a cero las dos posiciones de la derecha de la actual, siempre podemos asegurarnos usando el siguiente fragmento: >[-]>[-]<<. Normalmente, sin embargo, no necesitaremos ejecutar este código, ya que estará a cero al comenzar.

Juntando todo esto, nos damos cuenta de que si al empezar tenemos en la posición p el valor a, en la posición p+1 el valor 0 y en la posición p+2 el valor 0, tras ejecutar el siguiente fragmento de código acabaremos teniendo en p el valor a, en p+1 el valor a, y en p+2 el valor 0:

[>+>+<<-]>>[<<+>>-]<<

¿Confuso? Considerando cada parte por separado, se ve claramente que simplemente estamos construyendo fragmentos cada vez más grandes mediante los bloques básicos que anteriormente hemos considerado.

Multiplicar un byte por una constante es sencillo: basta con utilizar el programa de mover, pero en lugar de incrementar una vez la variable de la derecha, la incrementamos tantas veces como haga falta. Por ejemplo, para multiplicar el byte actual por 7 podemos utilizar esto: [>+++++++<-], que deja el resultado a la derecha del byte actual, y éste a cero.

Multiplicar dos bytes entre sí requiere algo más de esfuerzo. La idea es sumar el segundo sobre el byte a su derecha tantas veces como diga el primero. Veamos cómo hacemos esto. Primero fijémonos en que la operación de copiar puede ser usada también para sumar, puesto que si el valor en la posición de la derecha de la actual no es cero, se le sumará el contenido del byte actual. Así pues, si llamamos c a la operación copiar, con este código resolveremos el problema: [>c<-], es decir, ir a la derecha, sumar el byte que hay allí al siguiente, ir a la izquierda, decrementar y continuar hasta que éste sea cero. Si se desea que no se pierda el primer multiplicando, habrá que empezar copiándolo a un lugar seguro.

El código completo queda así:

[>
  [>+>+<<-]
  >>
  [<<+>>-]
  <<
<-]

Veamos ahora un programa simple que imprime la «respuesta a la Gran Pregunta de la Vida, el Universo y Todo lo demás» (según Douglas Adams, escritor y humorista británico fallecido hace pocos años). Dicha respuesta es 42. El siguiente programa calcula el código ASCII del número 4 y lo imprime, y a continuación calcula el código ASCII del número 2 y lo imprime: +++++++[>+++++++<-]>+++.--.. El código ASCII del dígito 4 es 52 = 7×7+3, por tanto primero multiplicamos 7×7, y luego sumamos 3 al resultado y lo imprimimos. Después restamos 2 a lo que quedaba, ya que el código ASCII del dígito 2 es 50 = 52-2. Lo imprimimos, y ya lo tenemos.

Dejamos al cuidado del lector el resto del aprendizaje del lenguaje Brainfuck, para centrarnos en una forma de elaborar un intérprete de dicho lenguaje. Esta es una tarea realmente sencilla, como veremos enseguida; la única parte que presenta alguna complicación (poca, realmente) es llevar el balance de qué «]» corresponde con un «[» y viceversa. Precisamos de dos memorias, compuestas por sendos arrays (o arreglos, según algunos traductores): la de programa y la de datos, llamadas respectivamente mp y md. También necesitaremos dos variables: p y d, que serán los punteros de programa y datos, respectivamente.

He aquí un esquema del algoritmo principal del intérprete:

  Leer el programa en la memoria de programa, mp,
    guardando en la variable pfin la posición siguiente
    a la última usada, que indicará fin de programa.
  Poner a cero todos los elementos de la memoria de datos.
  Hacer p = 0, d = 0.
  Comienzo del bucle (1):
    Si p = pfin, fin de programa: ir a la etiqueta (4).
    Si la instrucción mp[p] es «-», hacer md[d] = md[d] - 1.
    Si la instrucción mp[p] es «+», hacer md[d] = md[d] + 1.
    Si la instrucción mp[p] es «<», hacer d = d - 1.
    Si la instrucción mp[p] es «>», hacer d = d + 1.
    Si la instrucción mp[p] es «,», leer un carácter y guardarlo en md[d].
    Si la instrucción mp[p] es «.», escribir el carácter que hay en md[d].
    Si la instrucción mp[p] es «[» y md[d] es cero, hacer lo siguiente:
      Hacer nivel = 0.
      Comienzo del bucle (2):
        Si mp[p] es «[», hacer nivel = nivel + 1.
        Si mp[p] es «]», hacer nivel = nivel - 1.
        Hacer p = p + 1.
        Si nivel = 0, ir al comienzo del bucle (1).
      Ir al comienzo del bucle (2).
    Si la instrucción mp[p] es «]», hacer lo siguiente:
      Hacer nivel = 1.
      Comienzo del bucle (3):
        Hacer p = p - 1.
        Si mp[p] es «]», hacer nivel = nivel + 1.
        Si mp[p] es «[», hacer nivel = nivel - 1.
        Si nivel = 0, ir al comienzo del bucle (1).
      Ir al comienzo del bucle (3).
    Hacer p = p + 1.
  Ir al comienzo del bucle (1).
  Etiqueta (4): fin de programa.

El intérprete recién descrito asume que los programas son sintácticamente correctos, es decir, que tienen un balance correcto de «[» y «]» y que el programa nunca utiliza la instrucción «<» cuando d = 0, ni la instrucción «>» cuando d está en la última posición disponible de md. También asume que el lenguaje efectúa correctamente el «salto» de 255 a 0 al incrementar, y de 0 a 255 en los decrementos. Si esto no fuera así, habrá que poner condiciones adicionales, convirtiéndose la operación de incrementar en la siguiente:

  Si md[d] = 255, hacer md[d] = 0; si no, hacer md[d] = md[d] + 1.

y la de decrementar, similarmente:

  Si md[d] = 0, hacer md[d] = 255; si no, hacer md[d] = md[d] - 1.

Durante el desarrollo de un programa Brainfuck es fácil equivocarse de forma que no cumpla los requisitos arriba expuestos. Para evitar sorpresas es aconsejable incluir en el intérprete comprobaciones en lugares estratégicos: comprobar antes de decrementar d que éste no es cero, y antes de incrementarlo que no está ya en el límite derecho; en los bucles que buscan el «[» y «]» correspondientes a su pareja, hay que comprobar que no llegamos a p = 0 o a p = pfin sin encontrar la pareja correspondiente, o en caso contrario detener la ejecución. Con esas precauciones el intérprete debería ser seguro frente a cualquier programa Brainfuck por mal construido que esté.

Ya para terminar, una pregunta: ¿cuál es la longitud del programa Brainfuck más corto capaz de escribir una o minúscula (código ASCII 111) dejando el resto de la memoria de datos con ceros?

Intérprete en JavaScript

El siguiente intérprete puede servir para probar código en Brainfuck. Incluye entrada y salida, pero no ejecución paso a paso ni visualización de los datos (véase la sección de enlaces para un depurador de Brainfuck más completo en C).

Programa: 
Entrada: 
Salida: 
Ejecutar: 

Enlaces

Por ahora la mayoría de las páginas enlazadas desde aquí están en inglés, ya que el tema parece que todavía no es muy conocido en nuestro país. Esperemos que con el tiempo la situación cambie.

Sobre lenguajes esotéricos en general

El lugar por excelencia donde encontrar información y referencias sobre lenguajes esotéricos es sin duda el Esoteric Languages Wiki:
http://www.esolangs.org/wiki/

Hay un índice de páginas apuntadas a un webring sobre lenguajes esotéricos, que también contiene multitud de referencias:
http://b.webring.com/hub?ring=esolang

Una excelente página dedicada a los lenguajes experimentales, mantenida por Chris Pressey:
Cat's Eye, http://catseye.tc/
Es de destacar la sección dedicada a los lenguajes de programación esotéricos:
http://catseye.tc/projects/eso.html

Eric S. Raymond es el autor de un compilador de INTERCAL, el C-INTERCAL. Su página llamada The Retrocomputing Museum contiene una selección de joyas del esoterismo en programación. Brainfuck tiene ocho instrucciones, pero ¿cuál es el mínimo número de instrucciones que debe tener un lenguaje para ser Turing-completo? ¡Una! Hay en esta página dos ejemplos, que llevan el concepto del RISC un paso más lejos: OISC (One Instruction Set Computing) y URISC (Ultimate RISC).
Otra de las joyas presentes en este museo es el kvikkalkul, un lenguaje pretendidamente utilizado en los submarinos nucleares suecos en la década de 1950, aunque más probablemente sea una broma. El lenguaje sólo soporta números en coma flotante sin parte entera, es decir, menores que 1.
También destacamos el MIXAL, que es el lenguaje ensamblador del procesador MIX de Knuth, mencionado en el texto, y un lenguaje de programación Klingon llamado var'aq. Hay muchas otras perlas que invitamos a descubrir.
http://www.catb.org/esr/retro/

La Enciclopedia de Lenguajes Estúpidos contiene una lista bastante exhaustiva de lenguajes esotéricos, sus características, el nombre de su creador, el año de creación y la página principal. Varios de los enlaces disponibles aquí han sido obtenidos gracias a esa página.
http://www.kraml.at/stupid/

Listas de correo relacionados con lenguajes esotéricos:
Archivo de la lista de correo de Cat's Eye

Selección de lenguajes esotéricos concretos

El lenguaje Whenever, cuyas instrucciones no se ejecutan en un orden preestablecido sino aleatorio:
http://www.dangermouse.net/esoteric/whenever.html

Las instrucciones del lenguaje Wierd son cambios de dirección en cadenas de símbolos. Esta es la especificación del lenguaje:
http://catseye.tc/projects/wierd/doc/wierdspec.txt

El lenguaje Piet mencionado en el texto, cuyas instrucciones son colores:
http://www.dangermouse.net/esoteric/piet.html

Descripción del lenguaje nihilista Sartre, creado por J. Colagioia, otro lenguaje pensado con buen humor. Es bastante llamativa la definición de la instrucción condicional IF.
http://catseye.tc/projects/sartre/doc/sartre.html

Sobre Brainfuck

He aquí un intérprete y depurador de Brainfuck escrito por el autor de este artículo (en inglés), suministrado en forma de código fuente en C. El código debería ser sumamente portable; compila perfectamente con gcc tanto en Windows como en Linux. El intérprete, además, realiza primero una pasada de optimización del código para que se ejecute más rápido. El depurador contiene funciones avanzadas que hasta ahora no he encontrado en ningún programa similar.
brfd101.zip (11.077 bytes)

Una completa guía acerca de los bloques con los que construir programas en Brainfuck:
http://home.planet.nl/~faase009/Ha_bf_intro.html

La demostración formal de que Brainfuck es Turing-completo:
http://home.planet.nl/~faase009/Ha_bf_Turing.html

Un intérprete de Brainfuck disponible en línea, escrito en JavaScript:
http://home.planet.nl/~faase009/Ha_bf_online.html

Propuestas de normalización del Brainfuck:
http://www.muppetlabs.com/~breadbox/bf/standards.html
y otra con cierto sentido del humor:
http://esoteric.sange.fi/ENSI/brainfuck-1.0.txt

Existen numerosos programas escritos en lenguaje Brainfuck; entre ellos destacamos un programa para averiguar si un número es primo, varios intérpretes y compiladores de Brainfuck escritos precisamente en Brainfuck, y un programa para calcular PI, aunque éste último requiere una extensión del lenguaje que permita que cada celda pueda almacenar números de 16 bits en vez de 8.

He aquí una biblioteca de programas escritos en Brainfuck. Destacamos el programa SORT.BF, que lee una entrada, la ordena mediante el método de la burbuja e imprime el resultado.
http://esoteric.sange.fi/brainfuck/bf-source/prog/

Otros enlaces indirectamente relacionados con lenguajes esotéricos

Una colección del programa Hello, World escrito en gran variedad de lenguajes, incluyendo muchos esotéricos, entre ellos BrainFuck e INTERCAL:
http://www.latech.edu/~acm/HelloWorld.shtml

99 Bottles of Beer es una canción popular inglesa y estadounidense, al estilo de la canción popular española cuya letra empieza así: Un elefante se balanceaba sobre la tela de una araña... La versión en inglés requiere contar del 99 al cero durante la canción. Escribir su letra es un ejercicio de programación indudablemente más complicado que el de Hello, World, ya que requiere un bucle finito, una cuenta atrás e imprimir números, y por ello los programas tienden a ser más largos pero a la vez más interesantes. He aquí una página dedicada a los programas que imprimen la letra completa de la canción 99 Bottles of Beer en diferentes lenguajes de programación; destacamos el escrito en A+ ya que es capaz de imprimir las versiones europea y americana. Por supuesto no faltan versiones Brainfuck ni INTERCAL del programa, e incluso una en Malbolge.
http://www.99-bottles-of-beer.net/

Los quines son programas capaces de reproducirse a sí mismos. No tienen, sin embargo, nada que ver con los virus: a diferencia de éstos, el requisito que han de cumplir los quines es que la salida del programa sea su propio código fuente, sin utilizar ningún fichero externo. Pensando un poco sobre el tema vemos enseguida que la tarea no es trivial, y que se parece al problema del huevo o la gallina. Hay ejemplos en muchos lenguajes, entre ellos INTERCAL y Brainfuck.
http://www.nyx.net/~gthompso/quine.htm

Lista exhaustiva de lenguajes de programación, antiguos y modernos:
http://ftp.wustl.edu/doc/misc/lang-list.txt

La Galería de los Descifradores CSS es una página creada para defender que un programa de ordenador puede ser acogido dentro de la ley de libertad de expresión, ya que al parecer un juez estadounidense declaró ilegal un programa escrito en lenguaje C que descifraba los sectores encriptados de los discos DVD, que utilizan un sistema criptográfico denominado CSS. Hay ejemplos en muchos otros lenguajes (entre ellos, cómo no, Brainfuck), y otras muchas formas de expresar el programa original: versiones recitadas del programa en formato MP3, descripciones detalladas del algoritmo paso a paso que pueden ser utilizadas para rehacerlo, y muchas otras divertidas maneras de convertir el algoritmo a formas que sí están claramente protegidas por la libertad de expresión. Dando vueltas a la tuerca, lleva el tema a extremos que rayan el ridículo, como la existencia de números primos ilegales.
http://www.cs.cmu.edu/~dst/DeCSS/Gallery/